Ollama + RAGで九州博士AIを作る
自分の資料を覚えるAI
はじめに: なぜRAGが必要なのか?
前回のai03「OllamaでローカルLLMを試す」では、自分のPCの中にAIサーバー (http://localhost:11434) を立てることができました。
しかし、実際に使ってみるとすぐに壁に当たります。
「指宿ってどこ?」
「指宿」は地名で、日本の熊谷市に属する地区の一つです。正確には、「指宿(さしかけ)」と表記されます。
主な特徴:
1. 所在地:日本の東京都西北部、埼玉県と境界を接しています。
2. 歴史:江戸時代から繁栄し、特に遊廓として知られました。現在も歴史的な町並みが残っています。
これが 「物知らず問題」 です。ローカルLLM (qwen2.5:7bやllama3.1:8b) は賢いですが、インターネットにないローカルな知識、2024年以降の新しい情報、あなたの手元の資料は知りません。そして分からない時に、もっともらしく嘘をつくことを ハルシネーション と呼びます。
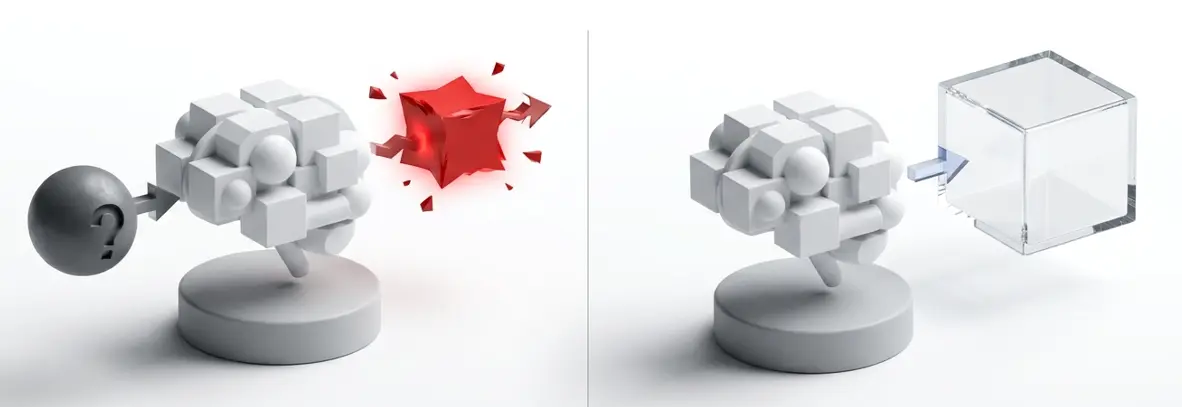
そこで今回は RAG (Retrieval-Augmented Generation / 検索拡張生成) を使います。
RAGは、AIに「カンニングペーパー」を渡してから答えさせる技術です。今回は九州7県の地名、産地、地理的特徴、県の個性をまとめたカンペを作り、 「何でも知ってる九州博士AI」 を自分のPCだけで作ります。
今回のゴール:
- RAGの仕組みを理解する
- 九州の知識データ(テキスト)を安全に作成する
- EmbeddingモデルとVectorDBを準備する
- PythonでRAGを動かし、RAGなしとの違いを体験する
RAGとは? 3つのステップ
RAGは難しく聞こえますが、やっていることは図書館の司書と同じです。
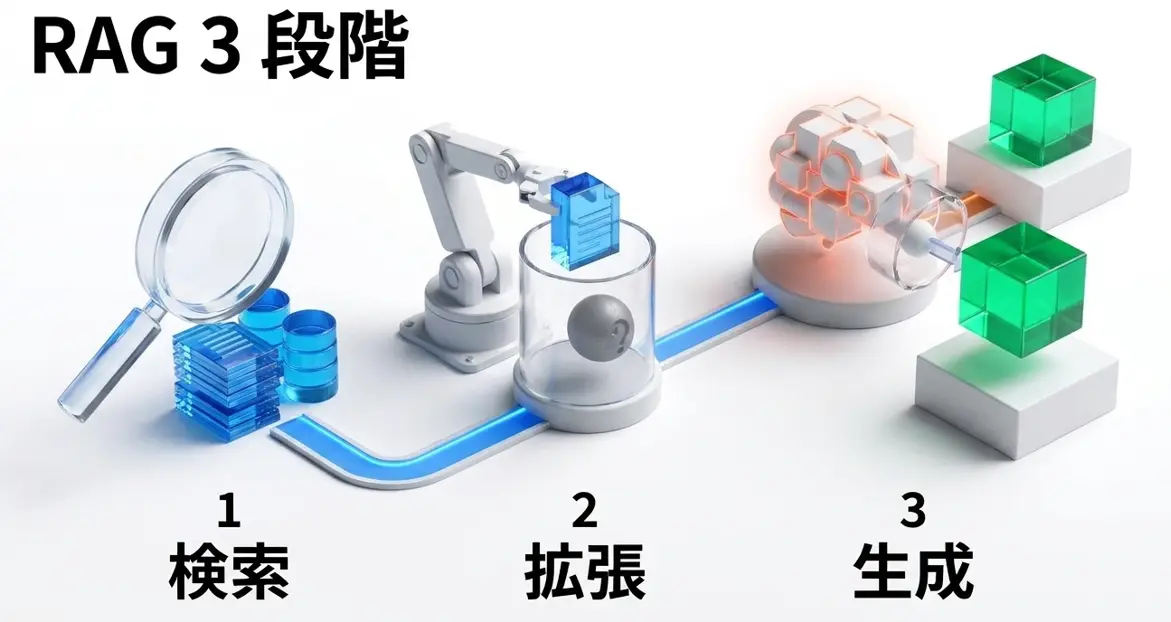
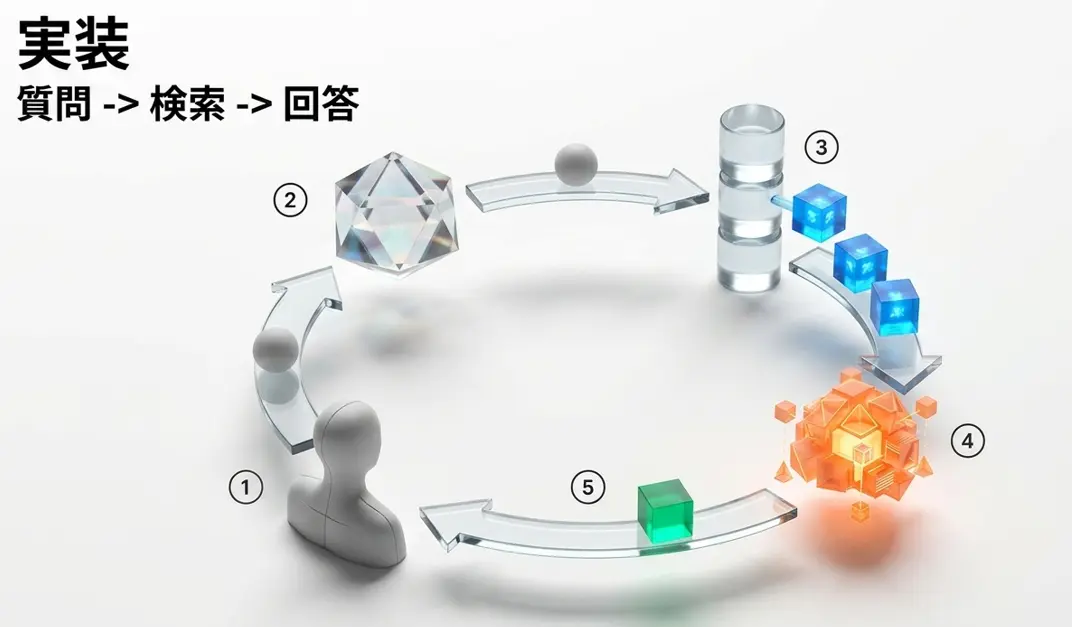
- 検索 (Retrieval): 質問が来たら、まず大量の資料の中から関係ありそうなページを探してくる
- 拡張 (Augmented): 「質問 + 探してきた資料」をセットにして、LLMに渡す
- 生成 (Generation): LLMは渡された資料を根拠にして、嘘をつかずに答える
重要なのは、LLM自体は何も覚え直さない、ということです。モデルはそのまま、外部の知識を付け替えるだけで賢くなります。だからプライバシーも守られ、オフラインでも動きます。
1. 準備するもの
ai03の環境に、2つだけ追加します。
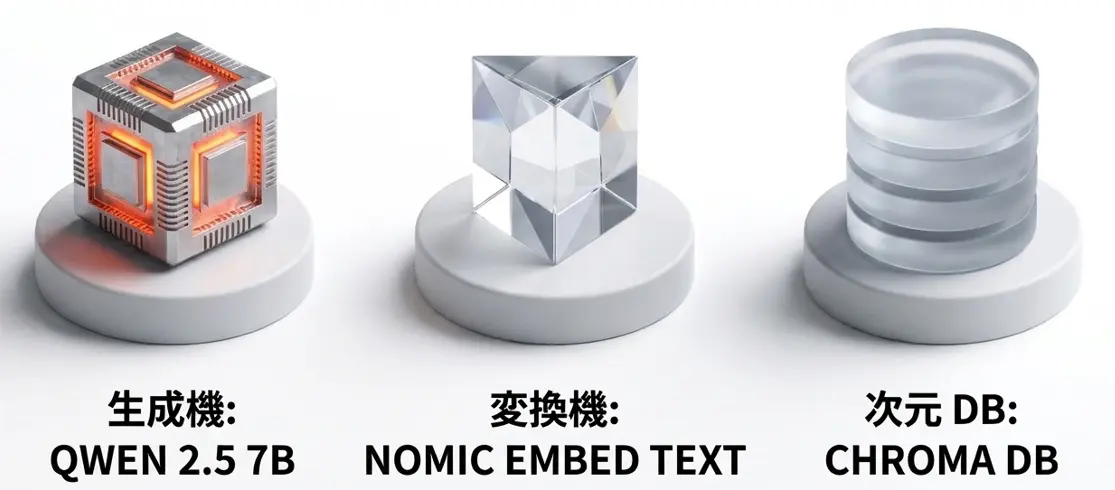
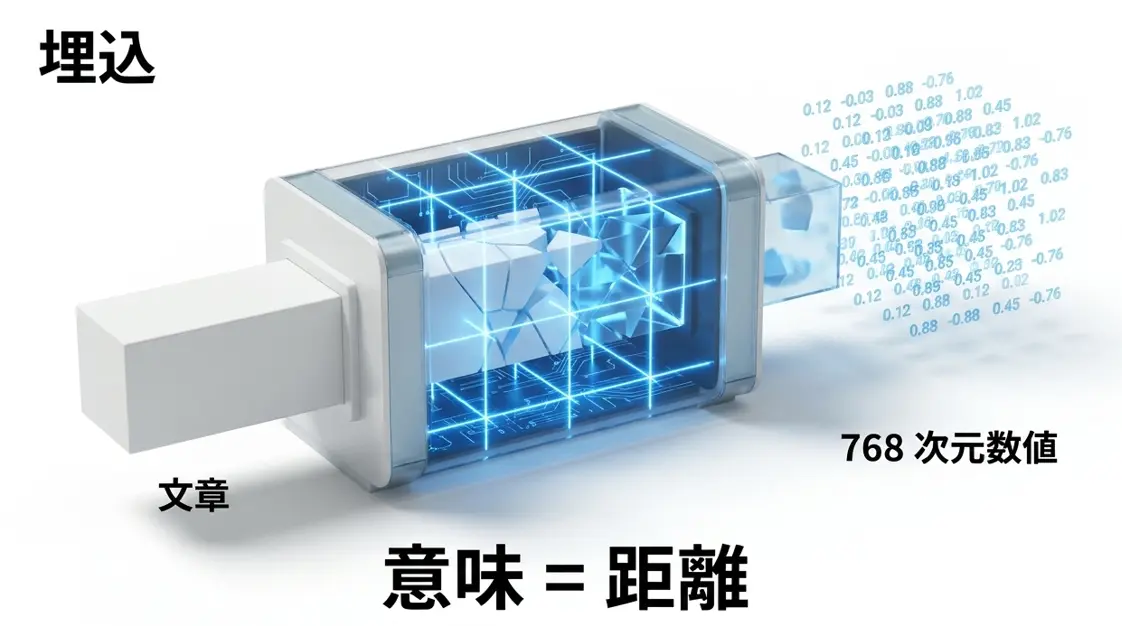
- Embeddingモデル: 文章を「意味のベクトル(数字の列)」に変換する翻訳機。意味が近い文章はベクトルも近くなる性質を使います
- VectorDB (ベクトルデータベース): ベクトル化した資料を保存し、高速に類似検索するための本棚
今回は初心者でも1コマンドで動く構成にします。
- Embedding:
nomic-embed-text(Ollamaで動く、軽量で日本語もOK) - VectorDB:
ChromaDB(Pythonだけで動く、ファイルに保存できる)
インストール
ターミナルで実行します。
ollama pull nomic-embed-text
ollama pull qwen2.5:7b  # 前回入れた回答用のモデル

pip install chromadb ollama langchain-text-splitters
教育現場のポイント: nomic-embed-text はメモリ2GB程度で動きます。mxbai-embed-large は精度が少し高いですが、もう少し重いです。まずはnomicで十分です。
2. 九州の知識データを作る - RAGの成否はここで決まる
RAGは資料が命です。AIに覚えさせたいことをテキストファイルにします。今回は例として data/ フォルダを作ります。
プロジェクト構成
ai04-kyushu-rag/
├── data/
│   ├── 99_kyushu.txt
│   ├── 01_kagoshima.txt
│   ├── 02_miyazaki.txt
│   ├── 03_kumamoto.txt
│   └── ...
├── build_db.py  # データをDB化する
└── ask.py        # 質問する
データ作成のコツ(重要)
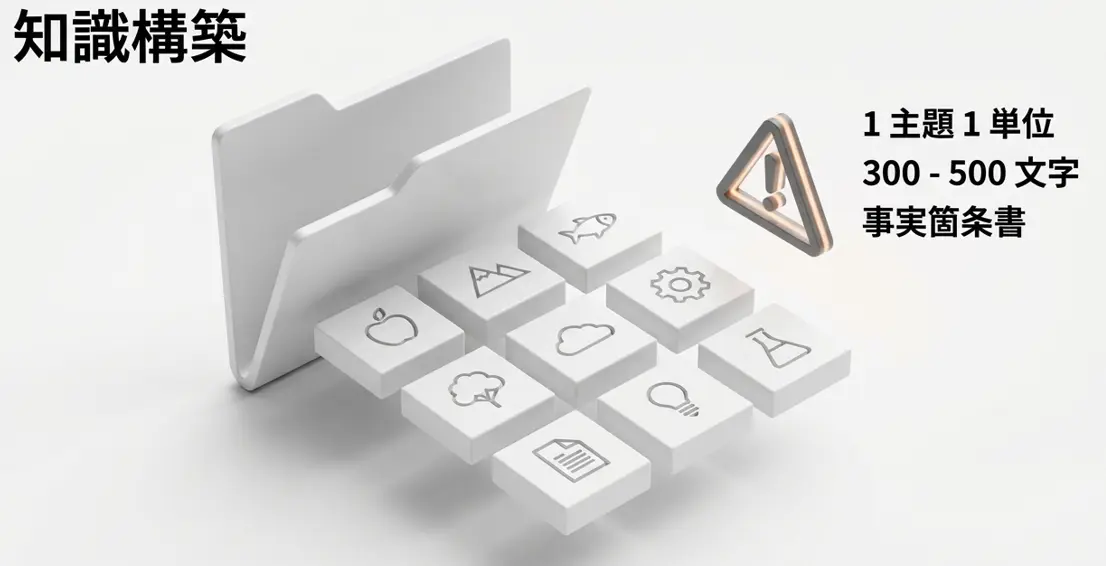
- 1ファイル1テーマ: 県ごとに分けると検索精度が上がります
- 読み方を書く: 九州の地名は難読が多いので、必ずふりがなを付けます。
指宿(いぶすき)のように - 短く区切る: 1段落300〜500文字を目安に。長すぎると検索がぼやけます
- 事実を箇条書きで: LLMが引用しやすい形にします
サンプルデータ: `01_kagoshima.txt`
## 地域概要

### 地理
- 鹿児島県は九州地方の最南端に位置する県である。
- 県域は薩摩半島と大隅半島の2つの半島と、多数の離島で構成される。
- 総面積は約9,185.91平方キロメートルで、全国10位、西日本では最大規模。
- 南北約600km、東西約270kmにわたり、緯度差が5度以上ある。
- 離島数は1,256島を数え、長崎県、北海道に次いで全国3位。

### 気候
- 県内で気象予報区分が複数に分かれる、日本で唯一の県である。
- 本土は九州南部、トカラ列島と奄美群島は奄美地方に区分される。

### 人口
- 2025年国勢調査確定値で総人口は151万1,783人、戦後最少を更新した。
- 2020年調査から7万6,473人減少し、減少率は4.8%で全国平均を上回る。
- 推計人口では2026年9月時点で約149万7,411人とされる。
同じ要領で、他県も作ります。
福岡県: 博多(はかた)、小倉(こくら) / あまおう、八女茶(やめちゃ) / 玄界灘(げんかいなだ)、筑後平野(ちくごへいや)
宮崎県: 日向(ひゅうが)、都城(みやこのじょう) / 宮崎牛、日向夏、マンゴー / 日向灘(ひゅうがなだ)、霧島連山
熊本県: 阿蘇(あそ)、天草(あまくさ) / 阿蘇あか牛、スイカ、デコポン / 阿蘇カルデラ、世界最大級
大分県: 別府(べっぷ)、由布(ゆふ) / カボス、関あじ・関さば / 別府湾、九重連山(くじゅうれんざん)
佐賀県: 唐津(からつ)、伊万里(いまり) / 佐賀牛、呼子(よぶこ)のイカ、有田焼 / 有明海の干潟
長崎県: 佐世保(させぼ)、諫早(いさはや) / 長崎和牛、五島(ごとう)のクエ / 島が多い、火山とリアス式海岸
ネット公開するなら - 公式情報から自分で作る方法
今回は資料自体は自分で作ってもらいますのでネットには公開しませんが、もしもネットに公開する場合、見つけた文章をそのまま貼り付けるのはNGです。鹿児島県公式サイトにも「著作権は県に帰属し、無断転載を禁じます」と明記されています。
ではどうするか? 「事実は誰のものでもない」 というルールを使います。
| 使ってOK | 使ってNG |
|---|---|
| 地名、読み方、標高、収穫量、位置などの事実 | 県のサイトのキャッチコピーや説明文をそのままコピペ |
| 自分の言葉で要約した文章 | Wikipediaの文章を出典なしでコピペ |
安全な作り方 3ステップ
ステップ1: 公式サイトで「事実メモ」を取る 下の一覧から3つのURLを開き、「いつ・どこで・何が・どれだけ」をメモだけ取ります。文章は写さない。
ステップ2: 自分の言葉で短く書き直す + ふりがなを付ける NG: 指宿の砂むし温泉は、海岸から湧き出る温泉で温められた砂に...(公式サイトの文章そのまま) OK: 指宿(いぶすき): 砂むし温泉(すなむしおんせん) - 海岸の砂に埋まる温泉。
ステップ3: 出典をファイル末尾に書く これで法的にも教育的にもクリアです。
---
出典・参考(事実をもとに筆者作成):
- 鹿児島県「絶品かごしまのブランド」 https://www.pref.kagoshima.jp/miryoku/syoku.html (2026-05-10閲覧)
- 農林水産省 九州農政局「鹿児島県の農林水産業」 https://www.maff.go.jp/kyusyu/kagoshima/ (2026-05-10閲覧)
Wikipediaを使う場合は、CC BY-SA 4.0の条件で出典を明記します: 出典: Wikipedia「鹿児島県」 https://ja.wikipedia.org/wiki/鹿児島県 CC BY-SA 4.0 をもとに要約
鹿児島県の参照すべき公式URL 3つ - ここから探そう
すべて自治体・省庁・公式観光協会の公開情報です。
鹿児島県
- 県公式ブランド(特産品): https://www.pref.kagoshima.jp/miryoku/syoku.html
- 県公式 かごしまの概要(地勢・地理): https://www.pref.kagoshima.jp/kense/shoukai/gaiyo/index.html
- 農林水産省 九州農政局 鹿児島拠点(農林水産統計): https://www.maff.go.jp/kyusyu/kagoshima/
これで作ったテキストは、あなたのオリジナル著作物になります。ネット公開しても安全で、RAGの精度も上がります(ふりがなを付けられるため)。
AIに作らせる(公開しない場合)
とはいえ、これらを注意してつくるのは大変骨の折れる作業です。楽をするためにAIを使うのに、準備が大変というのは変な話です。そこで今回は各県のデータは公開しない前提でAIに作らせる方法もやってみます。
プロンプトを作る
AIに依頼するには、プロンプトを正確に書く必要があります。これらのプロンプトはmarkdown書式で書くのがよいとされています。AIの出力は実はこのmarkdownでされています。なので、入力もmarkdownで行うとAIの受け取りが順序や階層が正しく伝わります。 こんなプロンプト作れないという人。大丈夫です。このプロンプトもAIに作らせました。作らせておいて、自分用に変更したらよいのです。そして、これで出来上がったmarkdownをさらに自分用に編集しましょう。
どのくらいの量のファイルを作るかは、実行するメモリー環境に依ります。今回は8GByteのパソコンで実行できる程度なので、500行が7県分で作ります。このプロンプトの対象地域の部分を各県に切り替えながら作ります。
あなたは優秀なリサーチャー兼テクニカルライターです。
指定された地域についての詳細な情報をWebから徹底的にリサーチし、約500行程度のマークダウン(Markdown)ファイル形式にまとめて出力してください。


【対象地域】: 鹿児島県
※他の県を調査する場合は「鹿児島県」を「福岡県」「熊本県」などに変更してください。


以下の各セクションに沿って、最新かつ正確な情報をバランスよく網羅してください。

1. 地域概要(地理・気候・人口・歴史的背景)
2. 主要都市とエリア特性
3. 主な産業・特産品(農林水産業、製造業、伝統工芸など)
4. 観光資源・歴史的建造物・自然名所
5. 独自の文化・食文化・方言や風習
6. 交通インフラ・主要アクセス
7. 山の名前・標高、川の名前、湾の名前・利用方法


* 検索結果や既存のWebサイト、百科事典等の文章をそのままコピー&ペーストすることは厳禁です。
* 複数の情報源から情報を照らし合わせたうえで内容を深く理解し、自分の言葉で分解・再構成(パラフレーズ)して文章を作成してください。
* 事実(ファクト)の抽出に留め、表現自体はオリジナルかつ平易で客観的な日本語に変換してください。
* 箇条書きや簡潔な文章を用いて、ローカルLLM(nomic-embed-text)のベクトル検索(RAG)で検索しやすい構造(文脈のまとまり)を意識してください。


* マークダウン形式(見出しレベル ##, ### を適切に使用)
* 行数の目安:全体で500行程度(極端に長すぎず短すぎない量)
* 出力コードブロック内に直接Markdownテキストを出力してください。
プロンプトから各県のデータを作る
あなたがいつも使っているAIに編集したプロンプトを与えて各県のRAG用のデータを作らせます。今回は公開用ではなく、自分で効果が分かるようにしたいので、ずるいですが、自分が質問する答えを含んだ文章を入れておきます。一般用ならば、それはできませんが、今回は自分用を作るという流れでやってください。
3. EmbeddingとVectorDBの準備 - 知識を数字に変える
Embeddingモデルとは?
nomic-embed-text は文章を768個の数字の列に変換します。例えば「桜島は活火山です」は [0.12, -0.03, 0.88...] のようなベクトルになります。「火山」という言葉を含む文章は、この数字が近くなる仕組みです。
ollama run nomic-embed-text
4. RAGを実装する - Pythonで動かす
いよいよ2つのPythonファイルを作ります。
`build_db.py` - 資料を覚えさせる (1回だけ実行)
import chromadb
import ollama
import os
from pathlib import Path
from langchain_text_splitters import RecursiveCharacterTextSplitter

EMBED_MODEL = "nomic-embed-text:latest"
DB_DIR = "./chroma_db"
DATA_DIR = "./data"
COLLECTION_NAME = "kyushu_knowledge"
BATCH_SIZE = 50  # 8G PCは一気にやると落ちるので小分け

client = chromadb.PersistentClient(path=DB_DIR)

try:
    client.delete_collection(COLLECTION_NAME)
    print("古いコレクションを削除しました")
except:
    pass

collection = client.create_collection(
    name=COLLECTION_NAME,
    metadata={"hnsw:space": "cosine"}
)

splitter = RecursiveCharacterTextSplitter(
    chunk_size=250,  # 250文字ごとに区切る
    chunk_overlap=50 # 50文字は重ねて文脈を保持
)
chunks_raw = []

for file in Path(DATA_DIR).glob("*.txt"):
    text = file.read_text(encoding="utf-8")
    chunks = splitter.split_text(text)
    for chunk in chunks:
        chunks_raw.append({"text": chunk, "source": file.name})
print(f"{len(chunks_raw)}個のチャンクを作成")

if len(chunks_raw) == 0:
    print("chunksが0件です。読み込み部分を確認してください")
    exit(1)

print(f"{len(chunks_raw)}件を {EMBED_MODEL} で埋め込みます...")

texts = []
metas = []
for idx, item in enumerate(chunks_raw):
    if isinstance(item, dict):
        # よくあるパターンを全部拾う
        txt = item.get('text') or item.get('content') or item.get('page_content') or item.get('document') or ""
        src = item.get('source') or item.get('metadata', {}).get('source') or f"doc_{idx}"
        texts.append(str(txt))
        metas.append({"source": str(src)})
    else:
        texts.append(str(item))
        metas.append({"source": f"doc_{idx}"})

print(f"{len(texts)}件を埋め込みます。先頭の型: {type(chunks_raw[0])}")
print(f"例: {texts[0][:80]}...")

for i in range(0, len(texts), BATCH_SIZE):
    batch_texts = texts[i:i+BATCH_SIZE]
    batch_metas = metas[i:i+BATCH_SIZE]
    batch_ids = [f"id_{j}" for j in range(i, i+len(batch_texts))]

    print(f"  {i+1}〜{i+len(batch_texts)}件目...")
    batch_embs = []
    for t in batch_texts:
        t_clean = t.strip() if t.strip() else "空のドキュメント"
        emb = ollama.embeddings(model=EMBED_MODEL, prompt=f"search_document: {t_clean}")["embedding"]
        batch_embs.append(emb)

    collection.add(
        embeddings=batch_embs,
        documents=batch_texts,
        ids=batch_ids,
        metadatas=batch_metas
    )

print(f"完了 count={collection.count()}")
実行:
python build_db.py
`ask.py` - 九州博士に質問する
import chromadb
import ollama
from openai import OpenAI

EMBED_MODEL = "nomic-embed-text:latest"  # 404対策で:latest付き推奨
LLM_MODEL = "qwen2.5:7b"  # 8GB PCなら "gemma3:4b" に変えてください
DB_DIR = "./chroma_db"

client_llm = OpenAI(base_url='http://localhost:11434/v1', api_key='ollama')
client_db = chromadb.PersistentClient(path=DB_DIR)

try:
    collection = client_db.get_collection("kyushu_knowledge")
except Exception as e:
    print(f"エラー: VectorDBが見つかりません。先に build_db.py を実行してください。\n{e}")
    exit(1)

def ask_kyushu(question: str):
    # 1. 質問をベクトル化して検索 (Retrieval)
    try:
        q_emb = ollama.embeddings(model=EMBED_MODEL, prompt=question)["embedding"]
        results = collection.query(query_embeddings=[q_emb], n_results=4)
    except Exception as e:
        print(f"Embeddingエラー: モデル {EMBED_MODEL} が見つかりません。")
        print(f"ターミナルで `ollama pull {EMBED_MODEL}` を実行してください。\n詳細: {e}")
        return

    context_docs = results["documents"][0]
    metadatas = results["metadatas"][0]
    context_text = "\n\n".join([f"[資料:{m['source']}]\n{d}" for d, m in zip(context_docs, metadatas)])

    # 2. プロンプトを拡張 (Augmented)
    # system_prompt = """あなたは九州地理と特産品に詳しい「九州博士」です。"""
    system_prompt = """以下のが質問に関係あれば使って、関係なければ無視してあなた自身の知識で答えてください。「参考情報にありません」とは言わないでください。"""
    user_prompt = f"""【資料】

{context_text}

【質問】

{question}

"""
    # 3. 生成 (Generation)
    try:
        res = client_llm.chat.completions.create(
            model=LLM_MODEL,
            messages=[
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": user_prompt}
            ],
            temperature=0.2
        )
        print("\n--- 参照した資料 ---")
        for m, d in zip(metadatas, context_docs):
            print(f"・{m['source']}: {d[:80]}...")
        print("\n--- 九州博士の回答 ---")
        print(res.choices[0].message.content)
    except Exception as e:
        print(f"LLMエラー: モデル {LLM_MODEL} が見つからないか、Ollamaサーバーが起動していません。")
        print(f"`ollama list` と `ollama serve` を確認してください。\n詳細: {e}")

if __name__ == "__main__":
    print("=== 九州博士AI (対話モード) ===")
    print(f"DB: {collection.count()}件 / LLM: {LLM_MODEL} / Embedding: {EMBED_MODEL}")
    print("質問をどうぞ。終了は q / exit / /bye / Ctrl+C")
    print("例: 指宿(いぶすき)の温泉の特徴は? / 宮崎牛の産地は?")
    while True:
        try:
            question = input("\n質問> ").strip()
            if not question:
                continue
            if question.lower() in ["q", "quit", "exit", "/bye", "bye", "終了"]:
                print("お疲れさまでした。終了します。")
                break
            ask_kyushu(question)
        except KeyboardInterrupt:
            print("\n終了します。")
            break
        except EOFError:
            print("\n終了します。")
            break
RAGなし vs RAGありの比較
同じ質問をOllamaに直接投げると...
ollama run qwen2.5:7b "指宿ってどこ"
RAGありだと...
pip install openai
python ask.py
この違いを授業で見せると、RAGの価値が一目で分かります。
5. 精度を上げる工夫 - より賢い博士に
工夫1: チャンクサイズの調整
- 地名や産地は 短い方が有利: 400文字
- 県の特徴や歴史は 長い方が有利: 600〜800文字
最初は400で作り、答えが途切れるなら600に上げてみましょう。
工夫2: 全体の特徴を九州として追加する
質問が「九州で一番・・・」などと質問されたらうまく答えられないときがあるので、全体を表す99_kyusyu.txtなどを追加しておくと良いでしょう。
## 地域概要

### 地理
- 日本列島を構成する主要4島のひとつで、南西部に位置する。
- 面積は約3万6782平方キロメートルで、本州、北海道に次ぐ大きさ。世界では37番目程度の島嶼規模。
- 北は関門海峡を挟んで本州と向き合い、東北は豊後水道を挟んで四国と近接する。
工夫3: プロンプトで「博士化」する
System Promptを工夫するだけで回答の質が変わります。
- NG: 「答えてください」
- OK: 「あなたは小学生にも分かるように九州の魅力を伝える博士です。難しい地名にはふりがなを。最後に『行ってみたくなる一言』を付け加えてください」
工夫4: 下手にRAGを使うとかえっておバカになることもある
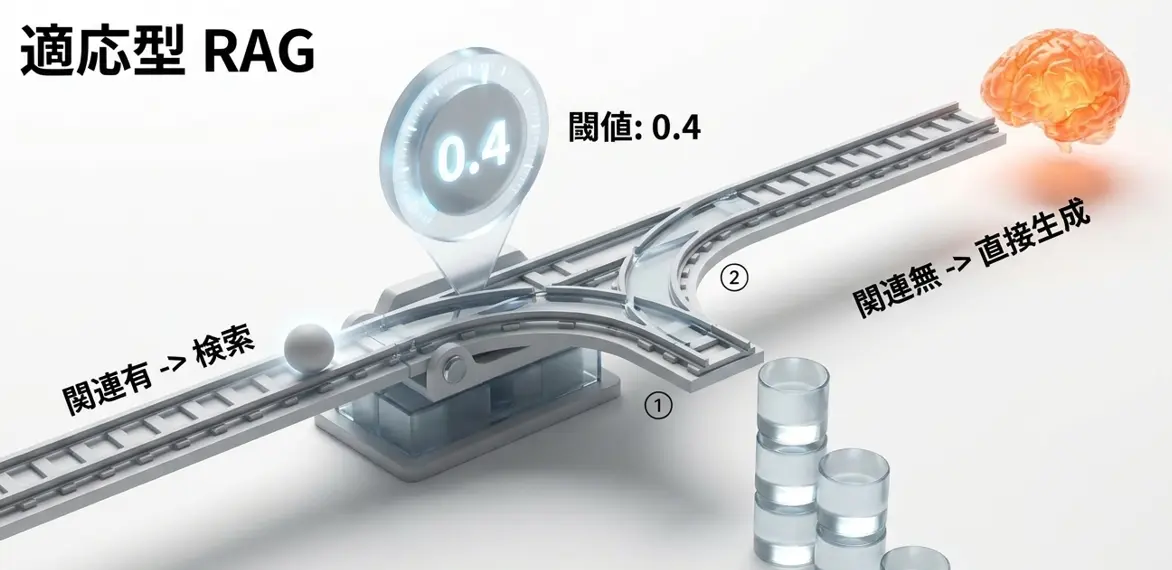
今回は、ちゃんと答えがもらえるように、質問に合わせた解答を書いたRAGになっています。しかし実際の場合はそんなことでは済みません。せっかく作ったのに、もともとのRAGを使わない解答の方が良い解答の場合が出てきます。そこで少し改造して、なにかしら回答があるときだけRAGを使用して、そうでない場合はRAGを使わないように自動的に切り替える方法があります。これをadaptive RAGといいます。では改造します
import chromadb
import ollama
from openai import OpenAI

EMBED_MODEL = "nomic-embed-text:latest"
LLM_MODEL = "qwen2.5:7b"
DB_DIR = "./chroma_db"

TOP_K_RETRIEVE = 6  # 最初は広めに6件取る
TOP_K_USE = 3       # 実際にLLMに渡すのは上位3件まで
DISTANCE_THRESHOLD = 0.4  # Chromaの距離がこれ以上ならノイズ扱い

client_llm = OpenAI(base_url='http://localhost:11434/v1', api_key='ollama')
client_db = chromadb.PersistentClient(path=DB_DIR)

try:
    collection = client_db.get_collection("kyushu_knowledge")
except Exception as e:
    print(f"エラー: VectorDBが見つかりません。先に build_db.py を実行してください。\n{e}")
    exit(1)

def answer_direct(question: str):
    """RAGなしでgemma3本来の知識で答える"""
    system_prompt = "You are a knowledgeable guide about Kyushu, Japan. Answer concisely in Japanese."
    user_prompt = question
    res = client_llm.chat.completions.create(
        model=LLM_MODEL,
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        temperature=0.3
    )
    return res.choices[0].message.content

def answer_with_rag(question: str, context_docs, metadatas):
    """RAGありで答える。関係ない資料は無視して良いと明言する"""
    context_text = "\n\n".join([f"[資料:{m.get('source','unknown')}]\n{d}" for d, m in zip(context_docs, metadatas)])
    system_prompt = """You are a helpful assistant for Kyushu.
Use Context if it is useful for the Question.
If Context is NOT relevant, ignore it and answer from your own knowledge.
Do NOT say "参考情報にありません". Answer in Japanese."""

    user_prompt = f"""【参考資料】
{context_text}

【質問】

{question}

"""

    res = client_llm.chat.completions.create(
        model=LLM_MODEL,
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        temperature=0.2
    )
    return res.choices[0].message.content

def ask_kyushu_adaptive(question: str):
    # 1. Retrieval - 距離も一緒に取る
    try:
        q_emb = ollama.embeddings(model=EMBED_MODEL, prompt=question)["embedding"]
        results = collection.query(
            query_embeddings=[q_emb],
            n_results=TOP_K_RETRIEVE,
            include=["documents", "metadatas", "distances"]
        )
    except Exception as e:
        print(f"Embeddingエラー: {e}")
        return

    docs = results["documents"][0]
    metas = results["metadatas"][0]
    dists = results["distances"][0]

    # 2. Adaptiveの分岐: 距離でフィルタリング
    filtered = []
    for doc, meta, dist in zip(docs, metas, dists):
        if dist <= DISTANCE_THRESHOLD:
            filtered.append((doc, meta, dist))
    # 類似度順にソートして上位だけ使う
    filtered = sorted(filtered, key=lambda x: x[2])[:TOP_K_USE]

    print(f"\n[Adaptive判定] 検索{TOP_K_RETRIEVE}件中、有効{len(filtered)}件 (閾値 {DISTANCE_THRESHOLD})")

    for i, (d, m, dist) in enumerate(filtered):
        print(f"  {i+1}. dist={dist:.3f} | {m.get('source','')} | {d[:60]}...")

    if len(filtered) == 0:
        print("\n--- [モード: 直接回答] 参考資料が無関係なので、gemma3の知識で答えます ---")
        ans = answer_direct(question)
        print("\n--- 回答 ---")
        print(ans)

    else:
        print(f"\n--- [モード: RAG回答] 有効な資料{len(filtered)}件を使って回答 ---")
        use_docs = [x[0] for x in filtered]
        use_metas = [x[1] for x in filtered]
        ans = answer_with_rag(question, use_docs, use_metas)
        print("\n--- 回答 ---")
        print(ans)

if __name__ == "__main__":
    print("=== 九州博士AI Adaptive RAG版 ===")
    print(f"DB: {collection.count()}件 / LLM: {LLM_MODEL} / Embedding: {EMBED_MODEL}")
    print(f"閾値: {DISTANCE_THRESHOLD} / 取得{ TOP_K_RETRIEVE}件 -> 使用{TOP_K_USE}件")
    print("終了は q / exit")

    while True:
        try:
            question = input("\n質問> ").strip()
            if not question: continue
            if question.lower() in ["q", "quit", "exit", "/bye", "bye", "終了"]:
                break
            ask_kyushu_adaptive(question)
        except KeyboardInterrupt:
            break
これで実行すると、場合によってはRAGを使用しない場合が出てきます
質問> 指宿ってどこ

[Adaptive判定] 検索6件中、有効3件 (閾値 1.0)
1. dist=0.316 | 99_kyusyu.txt | ### 温泉地
- 源泉数は全国の約3割が九州に集中する。
- 別府温泉、由布院温泉、黒川温泉、雲仙温泉、霧島温泉、指宿...
2. dist=0.326 | 01_kagoshima.txt | ### 温泉・砂むし
- 指宿温泉の砂むし温泉は海岸に湧出する温泉熱で温められた砂に埋まる世界的に珍しい入浴法である。
...
3. dist=0.335 | 04_fukuoka.txt | - 福岡市地下鉄:空港線(福岡空港~姪浜)、箱崎線(中洲川端~貝塚)、七隈線(博多~橋本)。天神・博多間の移動は約5分。...

--- [モード: RAG回答] 有効な資料3件を使って回答 ---

--- 回答 ---
指宿は鹿児島県に位置する温泉地です。独特の砂むし温泉で知られており、海岸から湧き出る温泉熱で温めた砂に埋まるという珍しい入浴法が行われています。また、指宿周辺には霧島温泉郷も存在し、古くから湯治場として人気があります。

質問> 10-8=

[Adaptive判定] 検索6件中、有効0件 (閾値 0.4)

--- [モード: 直接回答] 参考資料が無関係なので、qwen2.5:7bの知識で答えます ---

--- 回答 ---
2
6. トラブルシューティング
- Q: 検索結果が全然関係ない資料ばかり
- A: Embeddingモデルが日本語をうまく理解できていません。
nomic-embed-textからmxbai-embed-largeに変えてbuild_db.pyを再実行してみてください。少し重くなりますが精度が上がります。また、データにふりがなを入れると改善します。
- Q: 回答が「資料にありません」ばかり
- A:
n_results=4をn_results=8に増やしてみてください。またはチャンクが長すぎて検索で埋もれています。chunk_size=400に下げてください。
- Q:
chromadbのインストールでエラー - A: Pythonのバージョンを確認してください。Python 3.10以上を推奨します。
pip install --upgrade pipしてから再試行してください。
- Q: 応答が遅い
- A: 2段階で重くなっています。1) Embedding生成 2) LLM回答。タスクマネージャーでメモリを確認し、他のアプリを閉じてください。
qwen2.5:7bをgemma3:4bに変えると速くなります。
- Q: 8GB PCで固まる
- A:
build_db.pyの時はollama stop qwen2.5:7bでLLMを止め、embeddingだけ動かしてください。質問時はLLM_MODEL = "gemma3:4b"に変えると安定します。各県のテキストは500行程度が快適です。
まとめと次回予告
今回はRAGの基本を、九州という身近なテーマで実装しました。
- RAGは 検索→拡張→生成 の3ステップ
- 知識は テキストファイル で用意し、ふりがなが重要
- ネット公開するなら、公式サイトから事実をメモして自分の言葉で書き直し、出典を書くのが最も安全で正確
nomic-embed-textでベクトル化し、ChromaDBに保存したask.pyで資料に基づく正確な回答ができた
これであなたのPCは、クラウドに頼らず、自分の資料だけを根拠に語る「九州博士」になりました。個人情報や学校の独自資料でも同じ方法でAI化できます。 ただ、期待したよりも少しおバカさんですね。これはしかたがないかもしれません。もともとのローカルLLMはかなりお勉強をしているものなので、付け焼刃のRAGは少しは約に立ちますが、RAGでなんでも行けるようにするには、かなりの準備とやはりかなりのメモリーが必要になります。
次回 ai05予告: グローバルLLMを使ってみる
次回は、ローカルLLMから離れてグローバルLLMを使用します。
- open routerとは?
- グローバルと云っても無料もある
--- 参考リンク
- Ollama Embedding: https://ollama.com/library/nomic-embed-text
- ChromaDB Docs: https://docs.trychroma.com/
- LangChain Text Splitters: https://python.langchain.com/docs/how_to/split_by_character/
- Open WebUI RAG: https://docs.openwebui.com/features/workspace/knowledge/
- 政府標準利用規約(第2.0版) CC BY 4.0互換: https://www.digital.go.jp/resources/open_data/public_data_license_v2_0
- e-Stat 政府統計: https://www.e-stat.go.jp/
- 国土地理院 地理院地図: https://maps.gsi.go.jp/